1 – Série statistique double
- On étudie simultanément deux caractères au sein d'une même population.
- Une série statistique à deux variables est constituée de deux listes de \(n\) valeurs \(x_{1}\), ... , \(x_{n}\) et \(y_{1}\), ... , \(y_{n}\) :
| Valeurs de \(x_{i}\) | \(x_{1}\) | \(x_{2}\) | \(x_{3}\) | ... | \(x_{n}\) |
|---|---|---|---|---|---|
| Valeurs de \(y_{i}\) | \(y_{1}\) | \(y_{2}\) | \(y_{3}\) | ... | \(y_{n}\) |
Dans certaines situations, il semble exister un lien entre les deux caractères : on parle alors de corrélation. On ne peut cependant pas affirmer que ce lien est un lien de cause à effet (causalité).
Exemple 1 :
Une étude statistique française donne une correspondance entre le prix moyen \(x_{i}\) d'un paquet de \(20\) cigarettes (en \(€\)) et le nombre \(y_{i}\) de cigarettes vendues chaque année (en dizaines de milliards).
Les données sont regroupées dans le tableau ci-dessous :
| Années | \(2001\) | \(2002\) | \(2003\) | \(2006\) | \(2012\) | \(2013\) | \(2016\) | \(2018\) |
|---|---|---|---|---|---|---|---|---|
| Prix : \((x_{i})\) | \(3{,}4\) | \(3{,}6\) | \(4\) | \(5\) | \(6{,}3\) | \(6{,}7\) | \(7\) | \(8\) |
| Nombre total : \((y_{i})\) | \(8{,}3\) | \(8{,}1\) | \(7\) | \(5{,}5\) | \(5{,}2\) | \(4{,}8\) | \(4{,}5\) | \(4\) |
2 – Nuage de points, Point moyen
Définition 1 :
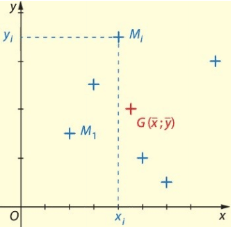 On se place dans un repère du plan.
- Une série statistique à deux variables se représente par un nuage de points de coordonnées \(M_{i}(x_{i};y_{i})\)
- On appelle point moyen du nuage le point \(G(\overline{x};\overline{y})\) où :
- \(\overline{x}\) est la moyenne de la 1re variable : \(\overline{x} = \dfrac{x_{1} + \ldots + x_{n}}{n}\)
- \(\overline{y}\) est la moyenne de la 2e variable : \(\overline{y} = \dfrac{y_{1} + \ldots + y_{n}}{n}\)
Exemple 1 (Suite) :
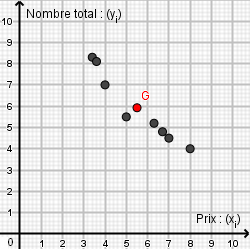
- Représenter dans le repère le nuage de points \(M_{i}(x_{i};y_{i})\) associé à la série ci-dessus.
- Calculer les coordonnées du point moyen \(G\) du nuage, puis le placer dans le repère.
\(\overline{y} = \dfrac{8{,}3 + 8{,}1 + \ldots + 4}{8} = 5{,}93\)
Le point moyen est donc \(G(5{,}5 ; 5{,}93)\).
3 – Covariance
Commençons par rappeler la définition de la variance (et de l'écart-type) pour une série simple :
Définition 2 :
On considère une série statistique \(x = (x_{1};\ldots;x_{n})\) de moyenne \(\overline{x}\).
On considère une série statistique \(x = (x_{1};\ldots;x_{n})\) de moyenne \(\overline{x}\).
- La variance est la moyenne des écarts au carré entre chaque valeur de la série et sa moyenne \(\overline{x}\) :
\(V(x) = \dfrac{(x_{1} - \overline{x})^{2} + \ldots + (x_{n} - \overline{x})^{2}}{n}\) - L'écart-type est alors le nombre \(\sigma(x) = \sqrt{V(x)}\)
Remarque :
- Dans la formule de la variance, le carré sert à obtenir un nombre positif qui mesure la distance entre chaque valeur et la moyenne. La racine carrée dans la formule de l'écart-type permet alors de revenir dans la même unité que les valeurs de la série. En pratique, on utilise donc plutôt l'écart-type que la variance.
- Ces deux paramètres mesurent la dispersion des valeurs de la série autour de leur moyenne : plus l'écart-type est grand, plus les écarts avec la moyenne sont importants et plus les valeurs seront éloignées les unes des autres.
Définition 3 :
On considère une série statistique à deux variables \(x = (x_{1};\ldots;x_{n})\) et \(y = (y_{1};\ldots;y_{n})\) de moyenne respective \(\overline{x}\) et \(\overline{y}\). La covariance de \(x\) et \(y\) notée \(\text{cov}(x;y)\) est le nombre défini par : \(\text{cov}(x;y) = \dfrac{(x_{1} - \overline{x})(y_{1} - \overline{y}) + (x_{2} - \overline{x})(y_{2} - \overline{y}) + \ldots + (x_{n} - \overline{x})(y_{n} - \overline{y})}{n}\)
\(= \dfrac{x_{1}y_{1} + x_{2}y_{2} + \ldots + x_{n}y_{n}}{n} - \overline{x}\,\overline{y}\)
On considère une série statistique à deux variables \(x = (x_{1};\ldots;x_{n})\) et \(y = (y_{1};\ldots;y_{n})\) de moyenne respective \(\overline{x}\) et \(\overline{y}\). La covariance de \(x\) et \(y\) notée \(\text{cov}(x;y)\) est le nombre défini par : \(\text{cov}(x;y) = \dfrac{(x_{1} - \overline{x})(y_{1} - \overline{y}) + (x_{2} - \overline{x})(y_{2} - \overline{y}) + \ldots + (x_{n} - \overline{x})(y_{n} - \overline{y})}{n}\)
\(= \dfrac{x_{1}y_{1} + x_{2}y_{2} + \ldots + x_{n}y_{n}}{n} - \overline{x}\,\overline{y}\)
Remarque : La covariance mesure si ces 2 variables « covarient » ensemble par rapport à leurs moyennes :
si les écarts à la moyenne ont tendance à être dans le même sens pour les deux variables alors la covariance sera positive ; s'ils ont tendance à être dans le sens opposé alors la covariance sera négative.
Plus la valeur absolue de la covariance est importante, plus il y a une corrélation entre ces deux variables.
Calculatrice : En pratique on utilise la calculatrice pour déterminer la variance, l'écart-type et la covariance.
Casio : Menu STAT, entrer les valeurs dans List 1 et List 2, puis configuration 2Var pour obtenir \(\overline{x}\), \(\overline{y}\), \(x\sigma n\), \(y\sigma n\) et \(\Sigma xy\).
TI : Touche STAT puis Editer, entrer les valeurs dans L1 et L2, puis CALC > Stats 2 Var pour obtenir \(\overline{x}\), \(\overline{y}\), \(\sigma x\), \(\sigma y\) et \(\Sigma xy\).
Casio : Menu STAT, entrer les valeurs dans List 1 et List 2, puis configuration 2Var pour obtenir \(\overline{x}\), \(\overline{y}\), \(x\sigma n\), \(y\sigma n\) et \(\Sigma xy\).
TI : Touche STAT puis Editer, entrer les valeurs dans L1 et L2, puis CALC > Stats 2 Var pour obtenir \(\overline{x}\), \(\overline{y}\), \(\sigma x\), \(\sigma y\) et \(\Sigma xy\).
Exemple 1 (Suite) :
Déterminer les écarts-types de \(x\) et \(y\) ainsi que la covariance de la série.\(\sigma(x) \approx 1{,}62\) et \(\sigma(y) \approx 1{,}55\).
\(\text{cov}(x;y) = \dfrac{\Sigma xy}{n} - \overline{x}\,\overline{y}\)
\(= \dfrac{241{,}3}{8} - 5{,}5 \times 5{,}93 = -2{,}425\)